机器学习和生物信息学实验室论坛联盟MAchine Learning And Bioinformatics, MALAB
查看: 6520|回复: 2

html网站整站抓取工具-FreshWebSuctions

[复制链接]
发表于 2012-3-20 19:41:17 | 显示全部楼层 |阅读模式
本帖最后由 xmubingo 于 2012-3-20 19:49 编辑

有时候我们在看人家网站的API或者说明文件,这些文件都是html组成的。

比如:http://59.77.16.75/documentation/php/index.html

很想把它们都copy下来放到自己的电脑上,因为怕对方网站哪天挂了就访问不了了。

需要一个整站抓取工具。

很像爬虫工具。全部宕下来。

FreshWebSuctions可以帮助你!

FreshWebSuctions.rar (824.39 KB, 下载次数: 2731)

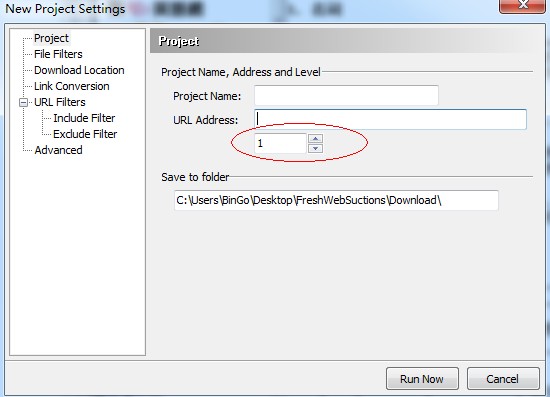
最重要的一个设置是level limit ,用来设置你要深入的层数。

1.jpg


另外再推荐一个软件WebRipper这个是抓取html页面中的特定资源,比如图片,链接文件等等
WebRipper_1.32.rar (861.21 KB, 下载次数: 1558)


回复

使用道具 举报

发表于 2012-3-20 20:22:49 | 显示全部楼层
哇,可以做镜像了!
回复

使用道具 举报

发表于 2012-3-21 10:48:31 | 显示全部楼层
very gooooooooood
回复

使用道具 举报

您需要登录后才可以回帖 登录 | 注册

本版积分规则

关注公众号
机器学习和生物信息学实验室联盟

相关侵权、举报、投诉及建议等,请发 E-mail:admin@discuz.vip

Powered by Discuz! X5.0 © 2001-2026 Discuz! Team.
在本版发帖
关注公众号
返回顶部