|
|
本帖最后由 ljy19940805 于 2016-8-24 16:18 编辑
论文标题:Probabilistic Community and Role Model for Social Networks
论文作者:Yu Han and Jie Tang
论文背景:
社交网络是一个大型的虚拟网络,其中可见的和不可见的元素相互连接并相互影响。结点和边是可见的元素,还有一些动态的元素如用户的行为;而社区、角色则是不可见的元素。
论文的主要工作:
这篇论文主要做了3个工作:1、用一个概率生成模型(CRM)包含了社交网络的各种元素,进一步设计了一个估计模型参数的方法 2、使用了模型来生成一个合成矩阵,并用6个指标来验证它的 优越性3、把模型应用于两个问题,行为预测和社区预测。
指导思想:
1、一个社交网络由许多的结点/用户组成,每一个结点由许多的边相连。这些边通常遵守一个分布规则:在一些特殊的组内是高度集中的,在组之间是稀疏的。结点之间是否有连接取决于它所在的社区。所以我们可以假设每个结点的社区分配上服从一个分布。
2、每个结点都有许多属性,如入度,出度和其它属性。基于这些属性我们可以对结点进行集群。每一个簇可以看成是结点所扮演的角色。例如:有高的入度的结点扮演是意见领袖的角色。每一个角色的属性满足一个特殊的分布———例如高斯分布。
3、每一个结点可以有一些动作,例如转发消息、评论图片。同一个社区的结点倾向于有类似的动作;也就是说一个几点是否采取特定的动作取决于它所在的社区。更进一步,一个结点的动作也取决与它的角色。因此,当我们考虑一个结点的动作时,我们必须结点在社区和角色上的分布。
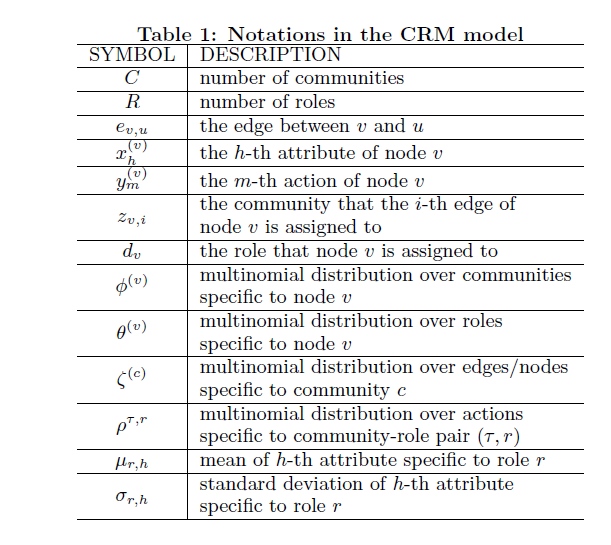
符号表示
模型描述
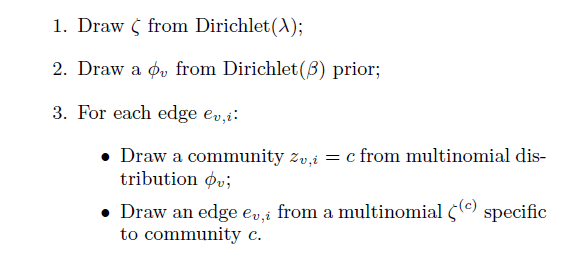
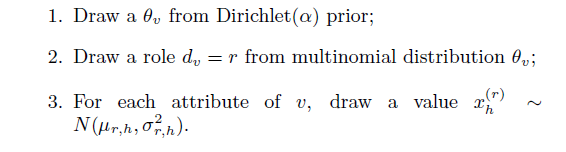
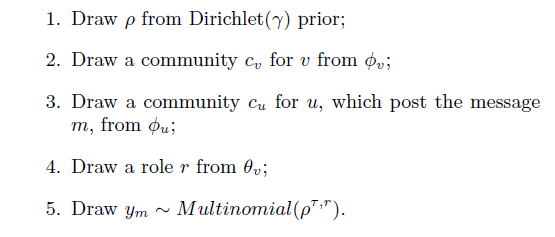
用一个概率生成模型CRM来代表社交网络。CRM假设一个社交网络可以由三个过程来生成,每一个过程都基于一个可见的元素——边,结点属性,动作。
1、 对图中的每一个结点
2、对图中的每一个结点
3、对图中的每一个动作
参数估计
直接解这些参数是不现实的,所以用了Gibbs采样来估计���参数
 和  。
首先,后验概率如下:
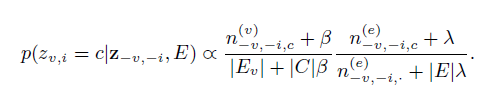
在Gibbs采样之后,参数估计如下:
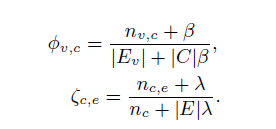
然后使用EM算法来估计参数
 ,  , 
似然函数如下:
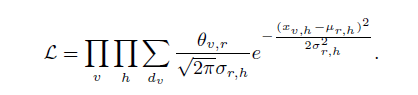
在E步:
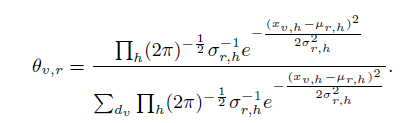
在M步:
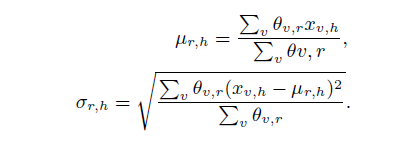
之后,在用Gibbs采样来估计

它服从后验概率
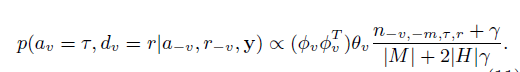
在采样之后参数估计如下:
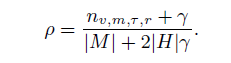
这样模型中的所有参数就都得到了,使用这些参数可以对模型进行应用,例如社区发现和行为预测。
实验结果
接下来要计算模型的有效性。首先使用真实的数据集来得到CRM的参数,然后使用这些参数来生成一个人工合成的网络。然后用下面三个任务来评价CRM:1、结构恢复2、行为预测3、社区检测
1、结构恢复
使用CRM模型得到的参数来生成一个人工合成的网络,如果生成的网络与实际的网络越相似,则模型越好。将MAG模型来当做一个基准,因为它是对网络建模的最好的方法。在这里使用了6种指标来衡量结构的差异:度、边的数量、特征值、特征向量、聚类系数、Triangle Participation Ratio。结果如下:
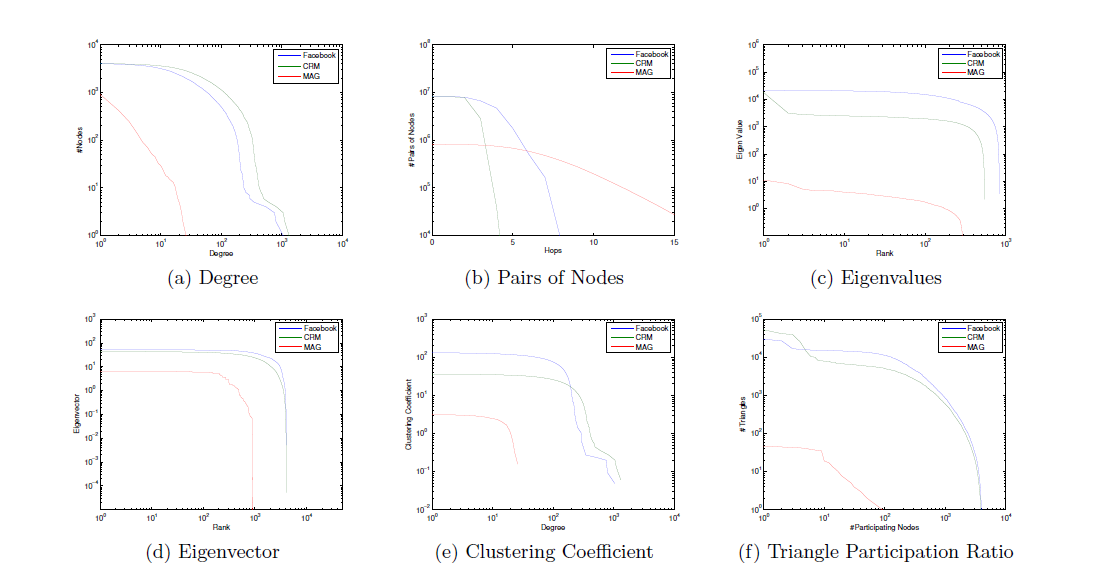
图中,CRM得到的结果与实际的网络十分的相近,所以CRM得到的结果比MAG的结果要好得多。
2、行为预测 这里把CRM方法同现有的算法如:Support Vector Machine (SVM), Sequential Minimal Optimization (SMO), Logistic Regression (LR), Naive Bayes (NB), Gaussian Radial Basis Function Neural Network (RBF), and C4.5进行比较。
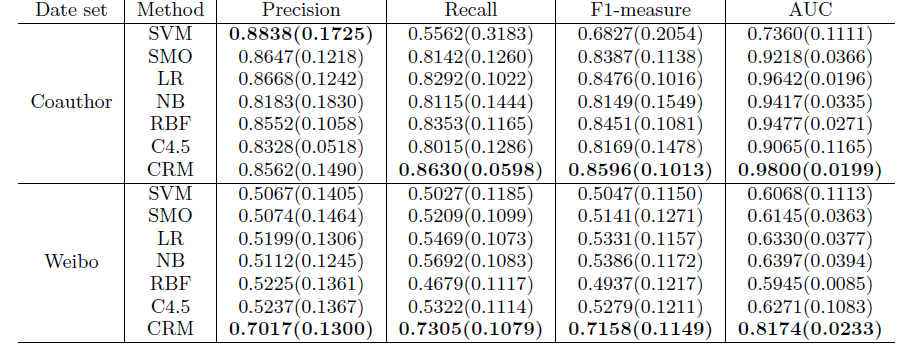
可以看到CRM的结果都比其他算法得到的结果要好。
3、社区检测
首先要确定社区的数量,所有将角色数量固定为6(一个实验可以证明log似然函数的值对于角色的数量不是十分敏感),设社区数量C=6, 20, 50, 100, 150, 200, 250, 300。然后计算它们的Log似然函数值,得到
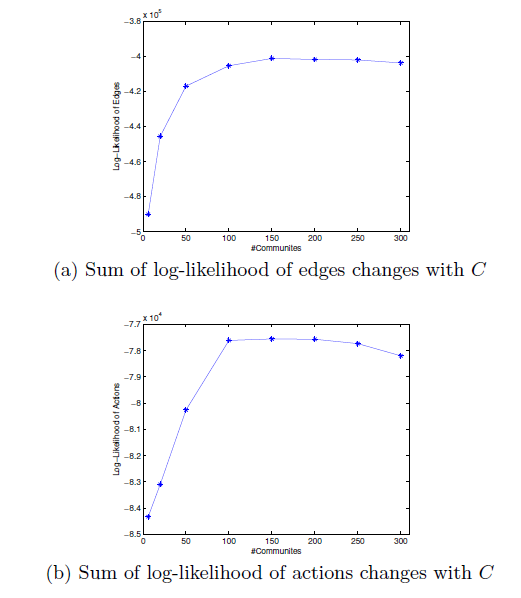
根据这个结果,选择社区的数量C=150。接下来列出了每个社区中最有代表性的5个人。
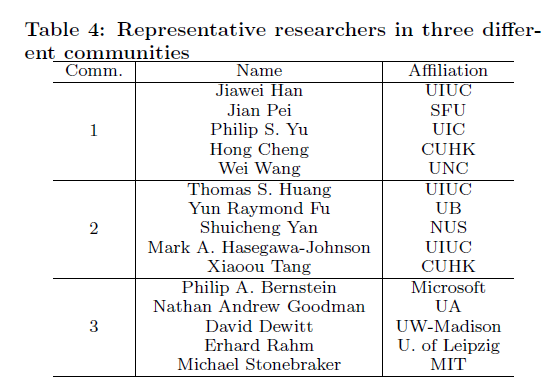
文章总结
这篇论文主要是构建了一个模型,它用到了它的所有信息,如连接、社区、角色、属性、动作。把这个模型应用于实际的网络中,可以得到比最好的方法还好的表现。同时可以把这个模型应用于许多的实际问题而不需要对模型进行修改,这也是这个模型的优越性。
|
|
 关注公众号

 发表于 2016-8-24 16:18:12