机器学习和生物信息学实验室论坛联盟MAchine Learning And Bioinformatics, MALAB
查看: 4767|回复: 2

Hadoop没学会,又出Haloop,情何以堪啊

[复制链接]
发表于 2011-9-16 17:56:39 | 显示全部楼层 |阅读模式
Hadoop的成功,让人们看到了使用普通商业集群处理大规模数据的合理性和必要性。
但是,目前在使用Hadoop处理数据的过程中,发现一些应用在处理迭代计算的过程中,例如机器学习、数据挖掘、网页排名等应用的过程中,Hadoop的MR框架有一定的不足。
不足主要存在于:
hadoop的中间数据要存储在本地磁盘,我们迭代的时候,存在本地磁盘的数据并没有变化,只是I/O,频繁的I/O降低了系统的性能。

在需求的驱动下,HaLoop提出了:
1 扩展mapreduce,支持迭代计算的编程模型。
2 使得任务调度对于跌倒操作敏感。
3 将loop-invariant data放在reduce节点的cache上,提升性能。

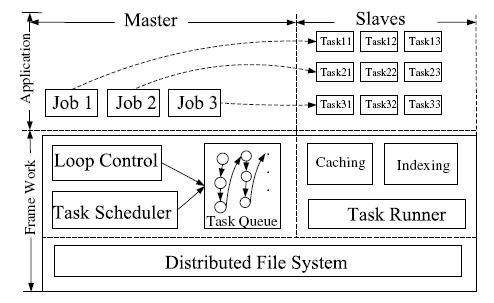
HaLoop的arch:

4a1f59bfg909298a7be11&690.jpg
一个master node,多个slave nodes。
jobs通过不同的clients发送到master节点,master节点控制作业的执行、调度,并把作业转换成在各个slave节点上执行的并行或者序列化的任务。
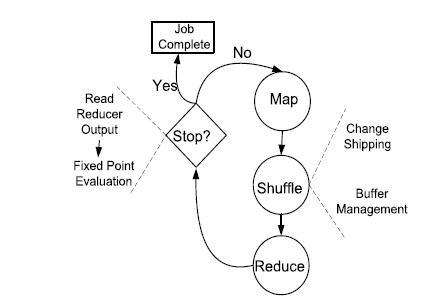
HaLoop的最大的特点是:Loop-Aware task scheduleing

show_mop.jpg
回复

使用道具 举报

发表于 2011-9-16 20:21:59 | 显示全部楼层
哇 技术更新的真是快啊 不变的就是变化啊
回复

使用道具 举报

发表于 2011-9-17 08:45:52 | 显示全部楼层
听起来好难,学起来不知道怎么样哈~
回复

使用道具 举报

您需要登录后才可以回帖 登录 | 注册

本版积分规则

关注公众号
机器学习和生物信息学实验室联盟

相关侵权、举报、投诉及建议等,请发 E-mail:admin@discuz.vip

Powered by Discuz! X5.0 © 2001-2026 Discuz! Team.

在本版发帖
关注公众号
返回顶部